東京大学 工学系研究科 電気系工学専攻 2022年8月実施 問題4 情報工学II
Author
donguri0912, meitmt, 祭音Myyura
Description
I.
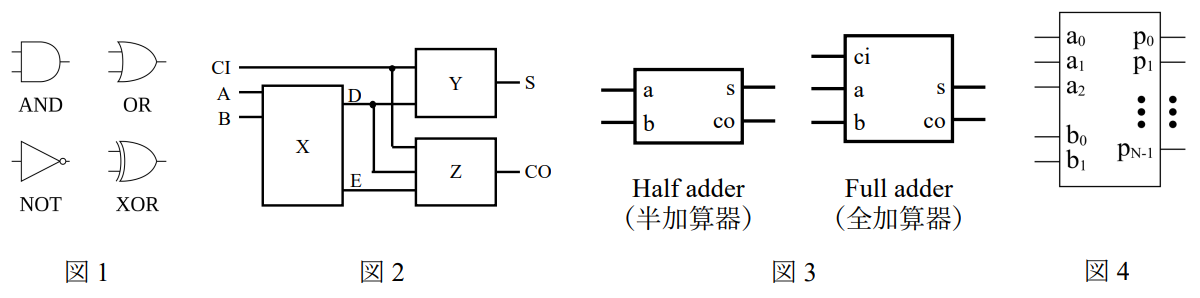
論理回路に関する以下の問に答えよ.回路図に使用する論理ゲートを図 に示す.AND, ORゲートの伝搬遅延時間がそれぞれ ps, NOTゲートの伝搬遅延時間が ps, XORゲートの伝搬遅延時間が psで,配線遅延は無視できるものとする.なお,クリティカルパス(入力から出力までの伝搬遅延時間が最も大きい経路)は入力と出力の組で示し,複数ある場合はすべて示すこと.
(1) 図 は,入力 A, B を,キャリー(桁上げ)入力 CI を考慮して加算し,和 S とキャリー出力 CO を生成する全加算器である.
- (1-i) 図 の X は,A, B の和 D とキャリー出力 E を生成する半加算器である.D, E の真理値表を示せ.また,図 の AND, OR, NOT ゲートのみを用いて X の回路を示し,クリティカルパスとその遅延を示せ.
- (1-ii) 図 のすべてのゲートが使用できるとき,クリティカルパスの伝搬遅延時間がより小さい X の回路を示せ.また,クリティカルパスとその伝搬遅延時間を示せ.
- (1-iii) Y,Z について,CI, D, E を入力,S, CO を出力とする真理値表を示し,クリティカルパスの伝搬遅延時間が最小となる回路を示せ.図 のすべてのゲートを使用してよい.また,X に問(1-ii)の回路を使用した場合のこの全加算器のクリティカルパスとその伝搬遅延時間を示せ.
以下では,半加算器は問(1-ii)で作成したもの,全加算器は問(1-iii)で作成したものを使用する.
(2) 全加算器を用いてキャリー入力を持つ符号なし ビット加算器を作成し,回路図を示せ.また,クリティカルパスとその伝搬遅延時間を示せ. 組の ビットの入力を と ,キャリー入力を ci,和を ,キャリー出力を coとする.全加算器の記号は図 のものを用いよ.
(3) 図 に示す, ビットの入力 と ビットの入力 とを持つ符号なし乗算器を考える.
- (3-i) 積 p のビット幅 N を答えよ.
- (3-ii) 半加算器,全加算器を少なくともひとつずつ使用してこの乗算器を作成し,回路図を示せ.ただし,クリティカルパスの伝搬遅延時間をなるべく小さくすること.図 ,図 のすべての記号を用いてよい.また,クリティカルパスとその伝搬遅延時間を示せ.
II.
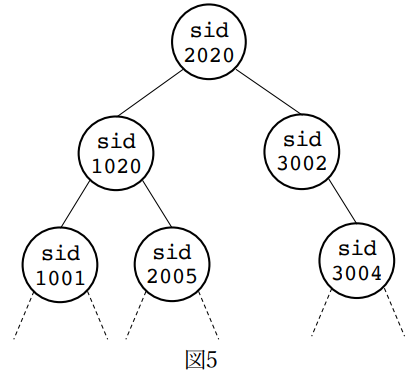
学生の学籍番号(sid)を, 分探索木を用いて管理する C 言語のプログラムを考える. 分探索木は,図 のように,各ノードに最大 個の子ノードが接続された木構造であり,ノードの値は,左の子ノードの値より大きく右の子ノードの値より小さいという制約がある.学籍番号を持つノードをプログラム の構造体で表現する.以下の問に答えよ.
(1) プログラム に,新しい sid を持つノードを追加する関数 add() を示す.空欄 A, B, C を埋めて完成させよ.
(2) 空の木に add() を使い以下の順で新しいノードを追加したときの 分探索木を図 の例に倣って書け.
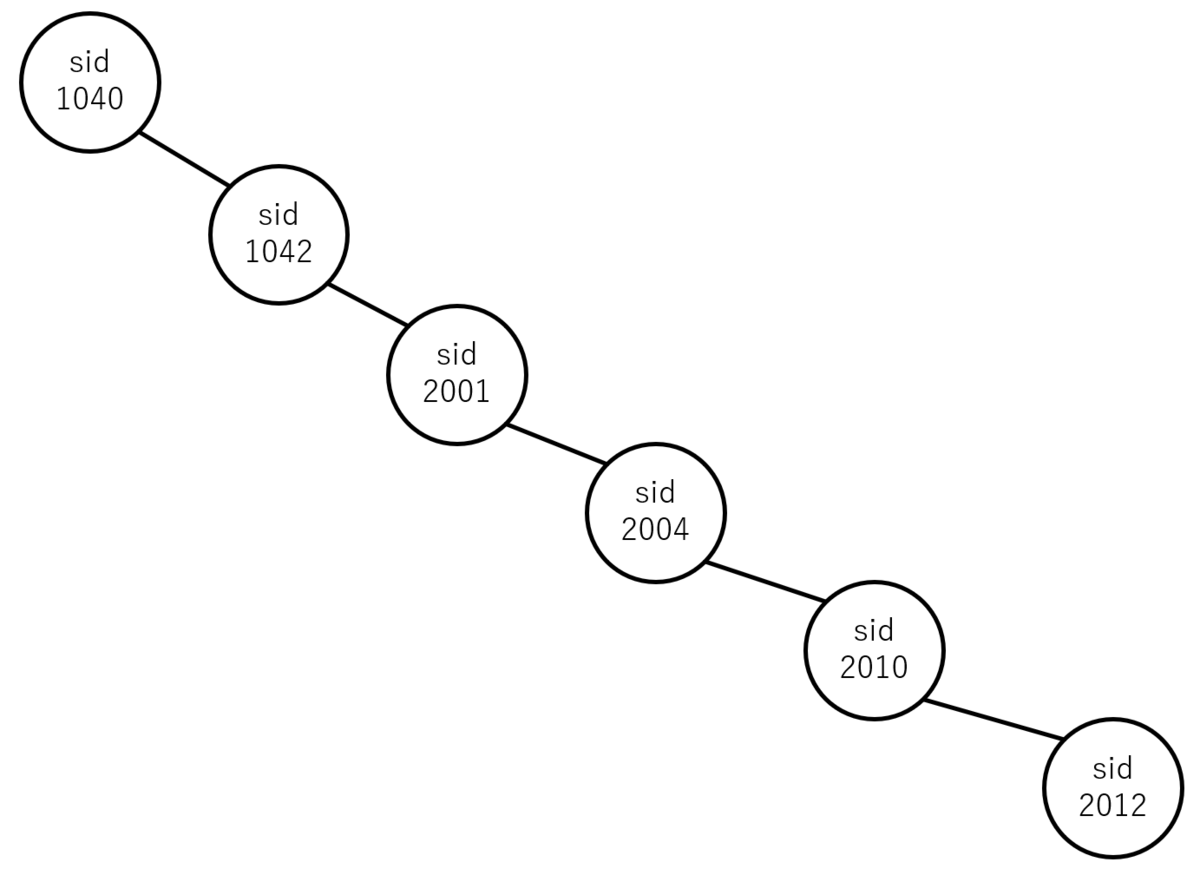
- (2-i) sid = 1040, 1042, 2001, 2004, 2010, 2012
- (2-ii) sid = 2001, 1042, 2010, 1040, 2004, 2012
(3) プログラム に sid を小さい順に列挙する関数 enumerate() を示す.空欄 D, E, F, G を埋めて完成させよ.
(4) ノードを 分探索木から削除する手順を,削除したいノードの子ノードが 個, 個, 個の場合について簡潔に説明せよ.
(5) 既に 分探索木上に存在するノードと同じ sid を持つノードを追加しようとした時の add() の振る舞いと問題点を簡潔に説明せよ.
(6) 追加する sid をあらかじめ用意された十分に大きな配列に先頭から追加順に格納する方法と比べ, 分探索木を用いる利点と欠点をそれぞれ簡潔に述べよ.その際,探索,要素の追加のそれぞれに必要な計算量のオーダーについて言及せよ.
/* プログラム1 */
typedef struct node {
    int sid;
    struct node *left;
    struct node *right;
} node_t;
/* プログラム2 */
node_t *add(node_t *root, node_t *new){
    if(root == NULL){
        return   A   ;
    }

    if(root->sid > new->sid){
           B   ;
    }
    else if(root->sid < new->sid){
           C   ;
    }
    return root;
}
/* プログラム3 */
void enumerate(node_t *root){
    if(   D   ){
           E   ;
    }
    printf("%d\n", root->sid);
    if(   F   ){
           G   ;
    }
    return;
}
题目描述
I. 回答以下逻辑电路问题。电路图使用的逻辑门见图1。AND、OR 门的传播延迟均为 ,NOT 门为 ,XOR 门为 ,连线延迟可以忽略。临界路径(输入至输出传播延迟最大的路径)应以输入和输出的组合表示;若有多条,须全部列出。
(1) 图2为一个全加器:考虑进位输入 后,将输入 相加,产生和 与进位输出 。
(1-i) 图2中的 是由 产生和 与进位输出 的半加器。写出 的真值表。仅用图1中的 AND、OR、NOT 门画出 的电路,并指出临界路径及其延迟。
(1-ii) 当可使用图1中的所有逻辑门时,画出临界路径传播延迟更小的 电路,并指出临界路径及其传播延迟。
(1-iii) 对 ,写出以 为输入、 为输出的真值表,并画出临界路径传播延迟最小的电路。可以使用图1中的所有逻辑门。若 使用第 (1-ii) 问的电路,指出这个全加器的临界路径及其传播延迟。
以下使用第 (1-ii) 问设计的半加器和第 (1-iii) 问设计的全加器。
(2) 使用全加器构成带进位输入的无符号三位加法器,并画出电路图。指出临界路径及其传播延迟。两组三位输入为 和 ,进位输入为 ,和为 ,进位输出为 。全加器使用图3的符号。
(3) 考虑图4所示、输入为三位 和两位 的无符号乘法器。
(3-i) 求积 的位宽 。
(3-ii) 至少使用一个半加器和一个全加器,构成该乘法器并画出电路图。尽可能减小临界路径传播延迟。可使用图1、图3中的所有符号,并指出临界路径及其传播延迟。
II. 考虑一个用二叉搜索树管理学生学号(sid)的 C 语言程序。如图5所示,二叉搜索树是一种每个结点至多连接两个子结点的树结构,结点的值须大于左子结点的值、小于右子结点的值。用程序1的结构体表示具有学号的结点。回答以下问题。
(1) 程序2为添加具有新 sid 的结点的函数 add()。填入空白 A、B、C,完成程序。
(2) 从空树开始,用 add() 按以下顺序添加新结点。仿照图5,分别画出所得二叉搜索树。
(2-i) sid = 1040, 1042, 2001, 2004, 2010, 2012
(2-ii) sid = 2001, 1042, 2010, 1040, 2004, 2012
(3) 程序3为按从小到大顺序列出 sid 的函数 enumerate()。填入空白 D、E、F、G,完成程序。
(4) 对希望删除的结点分别有0个、1个、2个子结点的情况,简述将其从二叉搜索树中删除的步骤。
(5) 当试图添加与树中已有结点具有相同 sid 的结点时,简述 add() 的行为及问题。
(6) 与预先准备足够大的数组、从头按添加顺序存储 sid 的方法相比,分别简述使用二叉搜索树的优点和缺点。须说明查找、添加元素各自所需计算量的阶。
/* 程序1 */
typedef struct node {
    int sid;
    struct node *left;
    struct node *right;
} node_t;

/* 程序2 */
node_t *add(node_t *root, node_t *new){
    if(root == NULL){
        return   A   ;
    }

    if(root->sid > new->sid){
           B   ;
    }
    else if(root->sid < new->sid){
           C   ;
    }
    return root;
}

/* 程序3 */
void enumerate(node_t *root){
    if(   D   ){
           E   ;
    }
    printf("%d\n", root->sid);
    if(   F   ){
           G   ;
    }
    return;
}
Kai
I.
(1)
(1-i)
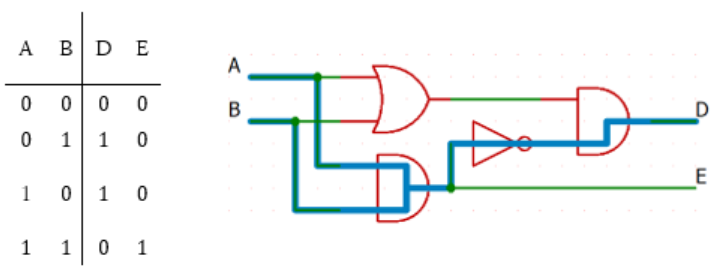
クリティカルパスの入力・出力の組は と 。
遅延は共に
(1-ii)
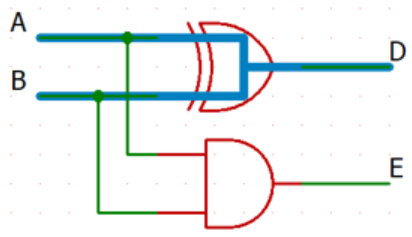
クリティカルパスの入力・出力の組は と 。
遅延は共に
(1-iii)
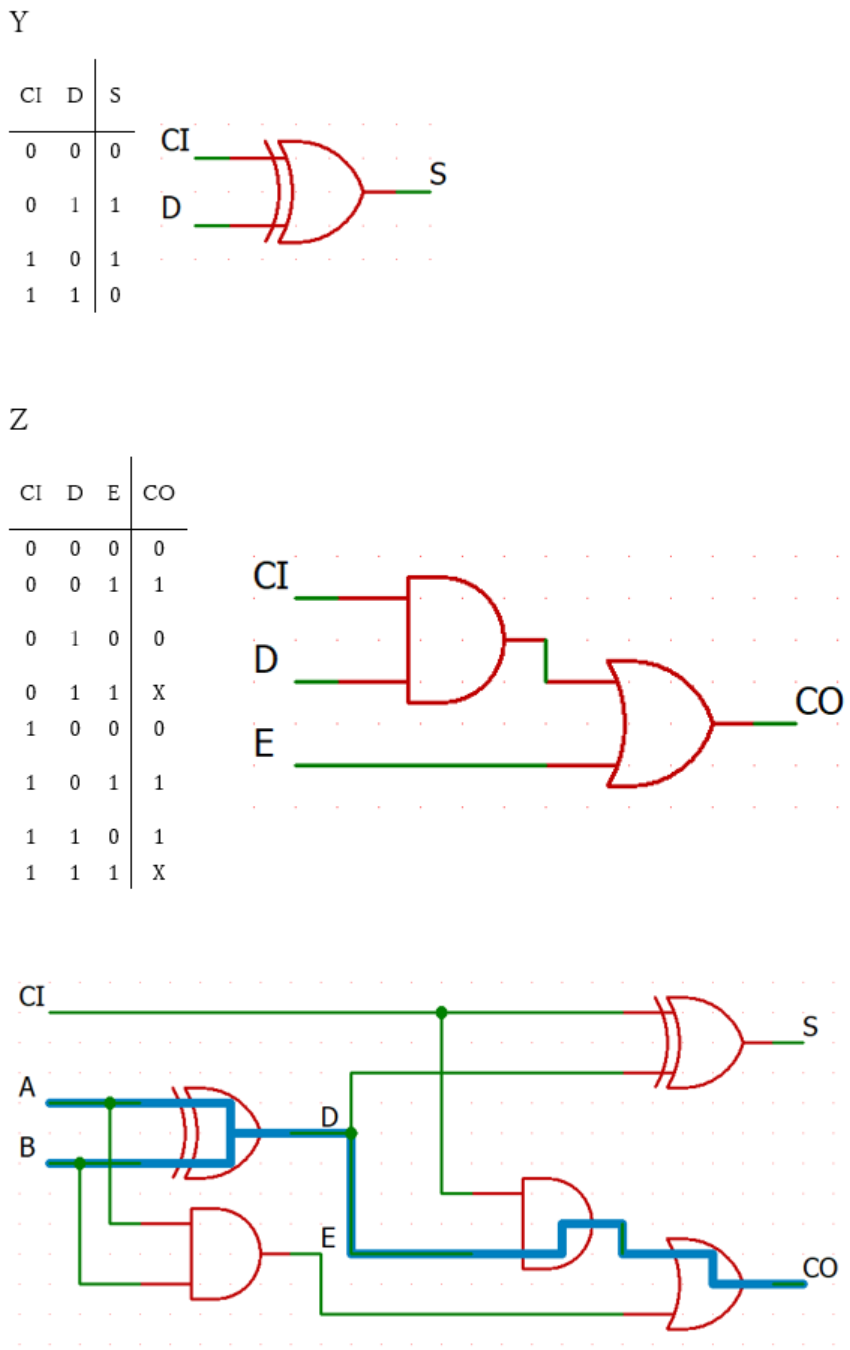
クリティカルパスの入力・出力の組は と 。
遅延は共に
(2)
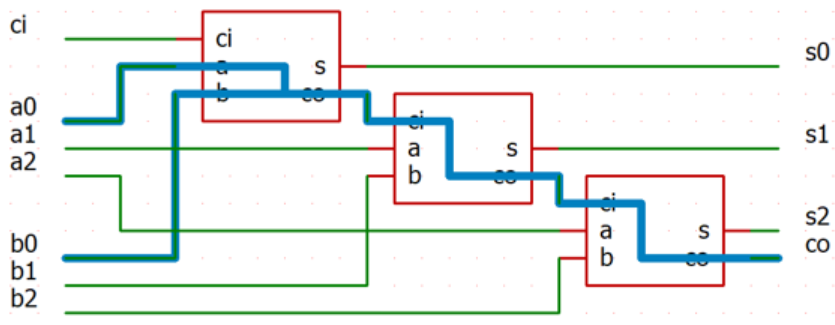
クリティカルパスの入力・出力の組は と 。
(1-iii) の全加算器で CI から CO の伝搬遅延時間は なので、
これらのクリティカルパスの伝搬遅延時間は共に
(3)
(3-i)
ビットの 進数の最大値は 、 ビットの 進数の最大値は 。
よって積 の最大値は
よって
(3-ii)
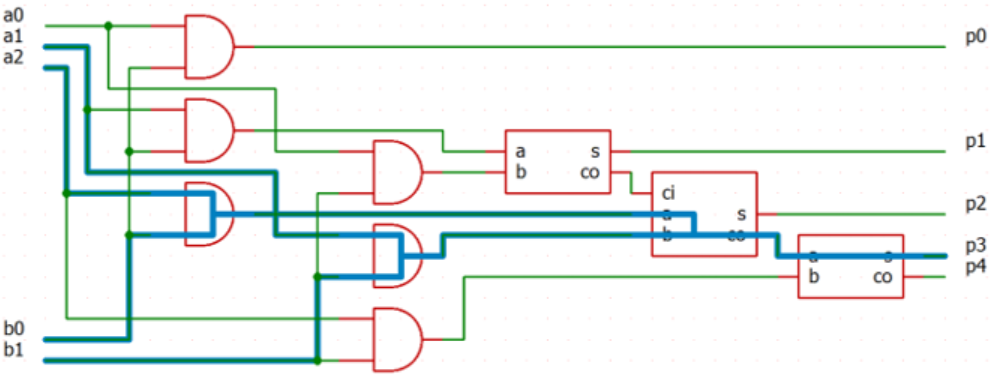
クリティカルパスの入力・出力の組は 、、、 の 組。
(1-iii) の全加算器で A から CO の伝搬遅延時間は なので、
これらのクリティカルパスの伝搬遅延時間は共に
II.
(1)
解答は分かりやすいよう空欄だけでなくその行ごと書いてある。
// A
return new;
// B
root->left = add(root->left, new);
// C
root->right = add(root->right, new);
追加する new の left と right はあらかじめ NULL に初期化する。
(2)
(2-i)
(2-ii)
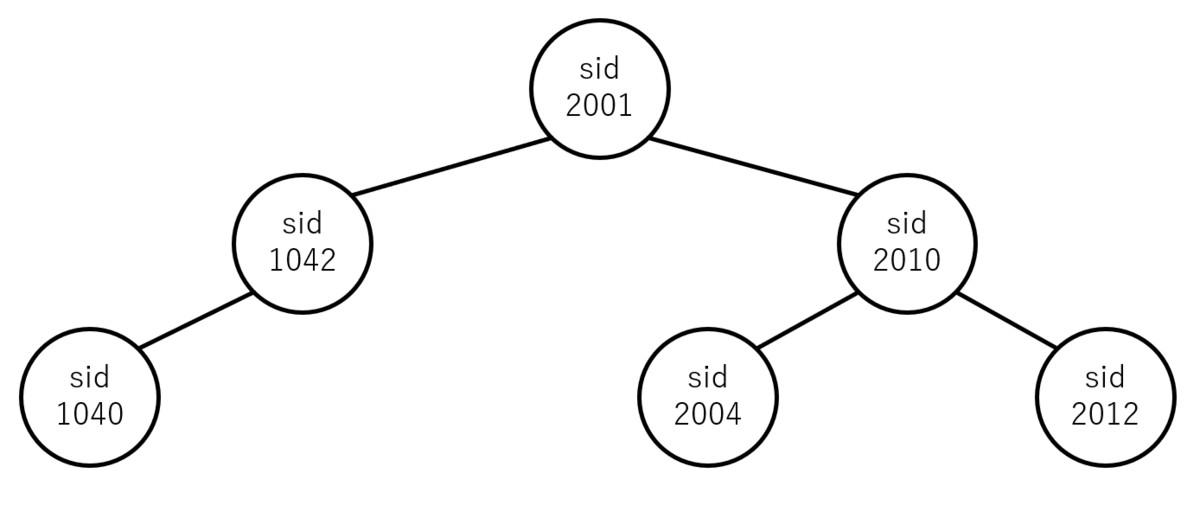
(3)
解答は分かりやすいよう空欄だけでなく周りごと書いてある。
// D, E
if (root->left != NULL) {
  enumerate(root->left);
}
// F, G
if (root->right != NULL) {
  enumerate(root->right);
}
空の木にも対応させる場合は、元の enumerate() の冒頭に if (root == NULL) return; を追加する。ここでの空欄 D〜G は、呼び出し時の root が非 NULL であることを前提としている。
(4)
個の場合、親からそのノードへのリンク(根なら根ポインタ)を NULL に変更し、そのノードを解放する。
個の場合、そのノードを消すと同時にその子ノードをそのノードがあった場所に引き上げる。
個の場合、そのノードを消すと同時に、右部分木の最小ノードを外して、そのノードがあった場所へと移動する。 この最小ノードをはずす際はノードを削除する手順を再帰的に適用する。
(5)
同じ sid を持つノードは追加されない。
問題点は一つの sid を複数個保持できず、new を別途解放しなければ未使用ノードのメモリが残ることである。
(6)
要素数を とすると、 利点は要素の探索にかかる平均計算量が の配列に比べて 分探索木は と短いことで、 欠点は要素の追加にかかる平均計算量が の配列に比べて 分探索木は と長いことである。
ただし は木が十分平衡な場合であり、偏った木では探索・追加とも最悪 となる。