名古屋工業大学 工学研究科 工学専攻 情報工学系 2024年8月実施 計算機ソフトウェア(データ構造とアルゴリズム)
Author
祭音Myyura (co-authored with GPT 5.6 SOL)
Description
I 次の (1)〜(3) の問いについて答えよ。
(1) 個の数値に対するソートアルゴリズムに関する以下の文章について,正しい場合は○,誤りの場合は×と答えよ。ただし,ここでのソートアルゴリズムは全て昇順ソートとし,数値がソートされても処理を途中で中断することはないものとする。
(i) バブルソートの最悪の時間計算量は である。
(ii) 昇順にソート済みの 個の数値が与えられた場合,挿入ソートは 時間で終了する。
(iii) 昇順にソート済みの 個の数値が与えられた場合,バブルソートは 時間で終了する。
(iv) クイックソートはピボットの決め方によらず の時間計算量となる。ピボットの選択自体にかかる時間計算量は無視できるとする。
(v) 比較ソートでは が最悪時の時間計算量の下界である。
(vi) 基数ソートは比較ソートの一種である。
(2) 以下の (i)〜(iii) は,A: 挿入ソート,B: 基数ソート,C: バブルソート,D: 選択ソートのいずれかのソートアルゴリズムを数値列 に適用した際の実行途中の数値列の状態を示している。1行目は初期数値列のため (i)〜(iii) で共通であり,2行目以後の数値列はそれぞれ異なるアルゴリズム中の別々の状態を抜き出したものである。ただし,いずれも下の行の数値列ほど処理が進んだ段階での状態である。また,最後の行はソート済みの数値列となっている。(i)〜(iii) のそれぞれについて,どのソートアルゴリズムによるものかAからDの中から選べ。
(i)
| 15 | 140 | 6 | 57 | 2 |
| 140 | 2 | 15 | 6 | 57 |
| 2 | 6 | 15 | 140 | 57 |
| 2 | 6 | 15 | 57 | 140 |
(ii)
| 15 | 140 | 6 | 57 | 2 |
| 15 | 6 | 57 | 2 | 140 |
| 6 | 15 | 2 | 57 | 140 |
| 6 | 2 | 15 | 57 | 140 |
| 2 | 6 | 15 | 57 | 140 |
(iii)
| 15 | 140 | 6 | 57 | 2 |
| 15 | 140 | 6 | 57 | 2 |
| 6 | 15 | 140 | 57 | 2 |
| 6 | 15 | 57 | 140 | 2 |
| 2 | 6 | 15 | 57 | 140 |
(3) 図1の Sort 関数はサイズ の数値配列 data と非負の整数 low と high を受け取り,マージソートにより昇順にソートを行うものとする。配列 data 全体をソートする場合は Sort(data, 0, N-1) のように呼び出しを行う。配列の添字は0から始まるとする(例えば,配列 data は data[0] から data[N-1] を要素とする)。また,if文の条件部において,(条件1 and 条件2)の条件2が評価されるのは条件1が真のときのみ,(条件1 or 条件2)の条件2が評価されるのは条件1が偽のときのみとする。次の (i)〜(ii) の問いについて答えよ。
(i) 図1の空欄 (A)〜(F) に適切な内容を入れよ。ただし,(A)〜(C) には 0, low, mid-1, mid, mid+1, high, N-1 のいずれかが入る( はグローバル変数として Sort 内からも参照可能とする)。また,(D) には,不等号 <= か >= のいずれかが入るものとする。
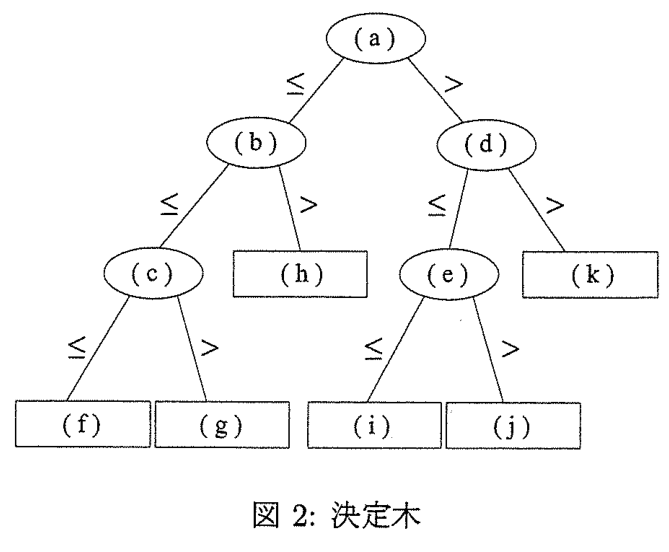
(ii) 配列 data に対して,数値列 がこの順で格納されているとする。この に対して図1のマージソートによる決定木を図2として作る。(a)〜(e) に入る適切な比較ペア及び (f)〜(k) に入るソートの結果をそれぞれ答えよ。ただし,(a)〜(e) については例えば と を比較する際は のように表記し,添字の小さいものを左側に表記すること。このとき,比較結果が なら左下の頂点へ, なら右下の頂点へ推移するものとする。(f)〜(k) については のように並び替えられた数値列を記載すること。
 1  Sort(data, low, high)
 2      if (low < high)
 3          mid に ((low + high) / 2) の小数点以下を切り捨てた値を代入する
 4
 5          Sort(data, [A], mid)
 6          Sort(data, [B], [C])
 7
 8          新規の配列 temp に数値列 data[low], data[low+1], ..., data[high] をこの順に格納する
 9          i = low
10          j = mid + 1
11          for (k = low to high)
12              if ((i <= mid) and ((j > high) or ([E] [D] [F])))
13                  data[k] = [E]
14                  i = i + 1
15              else
16                  data[k] = [F]
17                  j = j + 1
図1:マージソートの疑似コード
题目描述
I 回答以下 (1) 至 (3) 问。
(1) 对以下有关 个数值排序算法的陈述,正确答○,错误答×。所有算法均按升序排序,即使数值已排序,也不会提前中止处理。
(i) 冒泡排序最坏时间复杂度为 。
(ii) 若给出已经按升序排序的 个数值,插入排序会在 时间结束。
(iii) 若给出已经按升序排序的 个数值,冒泡排序会在 时间结束。
(iv) 快速排序无论如何选择枢轴,其时间复杂度都是 。枢轴选择本身的时间复杂度可以忽略。
(v) 比较排序最坏时间复杂度的下界为 。
(vi) 基数排序是一种比较排序。
(2) 以下 (i) 至 (iii) 表示将 A:插入排序、B:基数排序、C:冒泡排序、D:选择排序之一用于数列 时,执行过程中的状态。第一行为初始数列,因此三表相同;第二行起,各表摘录不同算法执行中的若干状态。越往下的行对应处理越靠后的阶段,最后一行均已排序。请分别从 A 至 D 中选择 (i)、(ii)、(iii) 对应的算法。
(i)
| 15 | 140 | 6 | 57 | 2 |
| 140 | 2 | 15 | 6 | 57 |
| 2 | 6 | 15 | 140 | 57 |
| 2 | 6 | 15 | 57 | 140 |
(ii)
| 15 | 140 | 6 | 57 | 2 |
| 15 | 6 | 57 | 2 | 140 |
| 6 | 15 | 2 | 57 | 140 |
| 6 | 2 | 15 | 57 | 140 |
| 2 | 6 | 15 | 57 | 140 |
(iii)
| 15 | 140 | 6 | 57 | 2 |
| 15 | 140 | 6 | 57 | 2 |
| 6 | 15 | 140 | 57 | 2 |
| 6 | 15 | 57 | 140 | 2 |
| 2 | 6 | 15 | 57 | 140 |
(3) 图1的 Sort 函数接收大小为 的数值数组 data 与非负整数 low、high,利用归并排序按升序排序。对整个数组排序时,调用 Sort(data, 0, N-1)。数组下标从0开始,例如 data 的元素为 data[0] 至 data[N-1]。在 if 的条件中,(条件1 and 条件2)仅在条件1为真时求值条件2;(条件1 or 条件2)仅在条件1为假时求值条件2。回答以下 (i)、(ii) 问。
(i) 在图1空格 (A) 至 (F) 中填入适当内容。其中 (A) 至 (C) 只能填 0, low, mid-1, mid, mid+1, high, N-1 之一; 是全局变量,在 Sort 内也可访问。(D) 只能填不等号 <= 或 >=。
(ii) 数组 data 按顺序存储 。对这三个数,图2是使用图1归并排序所形成的决策树。分别填入 (a) 至 (e) 的比较对,以及 (f) 至 (k) 的排序结果。比较对须将下标较小者写在左侧,例如比较 与 时写作 ;若比较结果为 ,转到左下结点,否则转到右下结点。(f) 至 (k) 请用类似 的形式写出排序后的数列。
 1  Sort(data, low, high)
 2      if (low < high)
 3          将 ((low + high) / 2) 向下取整后的值赋给 mid
 4
 5          Sort(data, [A], mid)
 6          Sort(data, [B], [C])
 7
 8          将 data[low], data[low+1], ..., data[high] 按此顺序存入新数组 temp
 9          i = low
10          j = mid + 1
11          for (k = low to high)
12              if ((i <= mid) and ((j > high) or ([E] [D] [F])))
13                  data[k] = [E]
14                  i = i + 1
15              else
16                  data[k] = [F]
17                  j = j + 1
图1:归并排序伪代码
Kai
(1)
- 。バブルソートの最悪時間は である。
- 。各挿入で直前の要素との比較だけで済むため、全体で である。
- 。途中終了をしない条件なので、比較回数は である。
- 。毎回極端に偏って分割されると になる。
- 。比較決定木には 個以上の葉が必要であり、高さは である。
- 。基数ソートは桁を利用する非比較ソートである。
(2)
(i) は一の位、十の位、百の位の順に安定ソートした状態なので、
である。
(ii) は各走査で未整列部分の最大値 が順に右端へ移動しているので、
である。
(iii) は左側の整列済み部分へ を順に挿入しているので、
である。
(3)
(i)
左右の再帰区間は と である。また、temp[0] は元の data[low] に対応するため、元配列の添字 に対応する一時配列の要素はそれぞれ temp[i-low], temp[j-low] である。左の要素を採用する条件は、右側を使い切ったか、両側に要素があり temp[i-low] <= temp[j-low] となる場合である。したがって、
(A) low
(B) mid + 1
(C) high
(D) <=
(E) temp[i - low]
(F) temp[j - low]
となる。
(ii)
最初の二要素のマージで を比較する。その後 を二要素の整列列へマージすると、空欄は次のようになる。
| 空欄 | 内容 |
|---|---|
| (a) | a1:a2 |
| (b) | a1:a3 |
| (c) | a2:a3 |
| (d) | a2:a3 |
| (e) | a1:a3 |
| (f) | |
| (g) | |
| (h) | |
| (i) | |
| (j) | |
| (k) |
三数が相異なる場合、各葉は 通りの大小順序に一対一に対応する。