九州大学 システム情報科学府 情報理工学専攻 2020年12月実施 オートマトンと言語
Author
祭音Myyura (co-authored with GPT 6 Astra)
Description
【問1】
状態数2の決定性有限オートマトンを考える。決定性有限オートマトン M=(K,Σ,δ,q0,F) において、K={q0,q1}、Σ={a,b}、F={q0} とする。ただし、K,Σ,δ,q0,F はそれぞれ M の状態集合、アルファベット、遷移関数、初期状態、最終状態の集合を表し、a と b は文字である。なお δ(p,x)=r(p,r∈K、x∈Σ)は、M が文字 x を読むことで状態 p から状態 r に移ることを表す。M によって受理される言語を L(M) で表す。Σ 上の正規表現 e(a,b) が表す言語を、∥e(a,b)∥ で表す。次の各問いに答えよ。
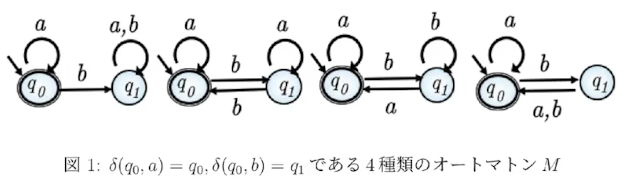
(1) 図1は、δ(q0,a)=q0, δ(q0,b)=q1 である4種類の δ に対応する M の状態遷移図である。図1の各 M について L(M) に含まれる文字列を説明せよ。
(2) δ(q0,a)=δ(q0,b)=q1 のとき、可能な M の状態遷移図を図1にならって全て与えよ。さらに、各 M について L(M) に含まれる文字列を説明せよ。
(3) 言語 L=∥e(a,b)∥ について、∥e(b,a)∥ を L の交換言語と呼ぶ。たとえば、L0 が文字 a を偶数個含む文字列から構成される言語であるとき、L0 の交換言語は文字 b を偶数個含む文字列から構成される言語である。
(1) と (2) とは異なる δ に対応する各 M に対し、(1) あるいは (2) の言語の交換言語とならない L(M) に含まれる文字列を説明せよ。
【問2】
文脈自由文法を4つ組 (N,Σ,P,S) で表す。ただし、N,Σ,P,S をそれぞれ非終端記号の集合、終端記号の集合、生成規則の集合、開始記号とする。Σ 上の文字列 w と終端記号 x∈Σ に対して、∣w∣x を w 中の x の出現数とする。以下の各問に答えよ。
(A) 以下に示す言語 Li(i=1,2,3)を導出する文脈自由文法 (Ni,Σi,Pi,S) の生成規則の集合 Pi を与えよ。
(1) L1={w∈{a,b}∗∣∣w∣a≥3}。ただし Σ1={a,b} である。答えには N1={S,X} を用いよ。
(2) L2={w∈{a,b}∗∣∣w∣a≥2∣w∣b}。ただし Σ2={a,b} である。答えには N2={S} を用いよ。
(3) L3={aibjck∣i,j,k≥0 かつ (2i=j または 3j=k)}。ただし Σ3={a,b,c} である。答えには N3={S,V,X,Y,Z} を用いよ。
(B) 以下に示す言語 L4,L5 は文脈自由言語であるか否か、証明せよ。
(4) L4=∅。
(5) 有限個の有限長文字列から構成される空でない任意の言語 L5。
题目描述
【问1】
考虑一个具有两个状态的确定性有限自动机 M=(K,Σ,δ,q0,F),其中 K={q0,q1}、Σ={a,b}、F={q0}。K,Σ,δ,q0,F 分别表示状态集合、字母表、转移函数、初始状态和接受状态集合,a,b 为字符。δ(p,x)=r(p,r∈K、x∈Σ)表示自动机读入字符 x 后从状态 p 转移到状态 r。用 L(M) 表示自动机接受的语言,用 ∥e(a,b)∥ 表示字母表 Σ 上的正则表达式 e(a,b) 所表示的语言。回答下列问题。
(1) 上方图1给出了满足 δ(q0,a)=q0, δ(q0,b)=q1 的全部四种转移函数对应的状态转移图。分别说明这些自动机接受的字符串。
(2) 当 δ(q0,a)=δ(q0,b)=q1 时,仿照图1,给出所有可能的状态转移图,并分别说明它们接受的字符串。
(3) 对于语言 L=∥e(a,b)∥,称 ∥e(b,a)∥ 为 L 的交换语言。例如,“包含偶数个 a 的字符串”所组成的语言,其交换语言是“包含偶数个 b 的字符串”所组成的语言。
对于转移函数不同于 (1)、(2) 的各个自动机,说明其中不属于 (1) 或 (2) 所得语言的交换语言的 L(M) 包含哪些字符串。
【问2】
用四元组 (N,Σ,P,S) 表示上下文无关文法,其中 N,Σ,P,S 分别为非终结符集合、终结符集合、产生式集合和开始符号。对于 Σ 上的字符串 w 与终结符 x∈Σ,用 ∣w∣x 表示 x 在 w 中出现的次数。回答下列问题。
(A)
给出生成下列语言 Li(i=1,2,3)的上下文无关文法 (Ni,Σi,Pi,S) 的产生式集合 Pi。
(1) L1={w∈{a,b}∗∣∣w∣a≥3}。终结符集合为 Σ1={a,b},必须使用非终结符集合 N1={S,X}。
(2) L2={w∈{a,b}∗∣∣w∣a≥2∣w∣b}。终结符集合为 Σ2={a,b},必须使用非终结符集合 N2={S}。
(3) L3={aibjck∣i,j,k≥0 且 (2i=j 或 3j=k)}。终结符集合为 Σ3={a,b,c},必须使用非终结符集合 N3={S,V,X,Y,Z}。
(B)
证明下列语言是否为上下文无关语言。
(4) L4=∅。
(5) 任意非空语言 L5,其中包含有限个有限长度的字符串。
Kai
【問1】
以下では ε を空文字列、+ を正規表現の和とする。初期状態 q0 が受理状態なので、どの M も ε を受理する。
(1)
図1を左から (i)、(ii)、(iii)、(iv) と呼ぶ。
| 図 | δ(q1,a) | δ(q1,b) | 受理する言語の正規表現 |
|---|
| (i) | q1 | q1 | a∗ |
| (ii) | q1 | q0 | a∗(ba∗ba∗)∗ |
| (iii) | q0 | q1 | ε+(a+b)∗a |
| (iv) | q0 | q0 | (a+b(a+b))∗ |
- (i) b を一度も含まない文字列である。b を読むと q1 に移り、その後は q0 に戻れない。
- (ii) b の出現数が偶数である文字列である。a は状態を変えず、b を読むたびに二つの状態を交互に移る。
- (iii) 空文字列、または末尾が a である文字列である。どちらの状態からも、a を読めば q0、b を読めば q1 になる。
- (iv) ブロック a、ba、bb の有限回の連結として表せる文字列である。q0 では a だけで1回の閉路となり、b で q1 へ移った場合は、その次の1文字が a,b のどちらでも q0 に戻る。したがって、左からこの規則で読み進めたとき、最後に未処理の b が残らないことが受理条件となる。
(2)
q0 からの二つの遷移が固定されているので、δ(q1,a) と δ(q1,b) の選び方は 22=4 通りである。全ての状態遷移図を以下に示す。二重丸が受理状態、外からの矢印が初期状態を示す。
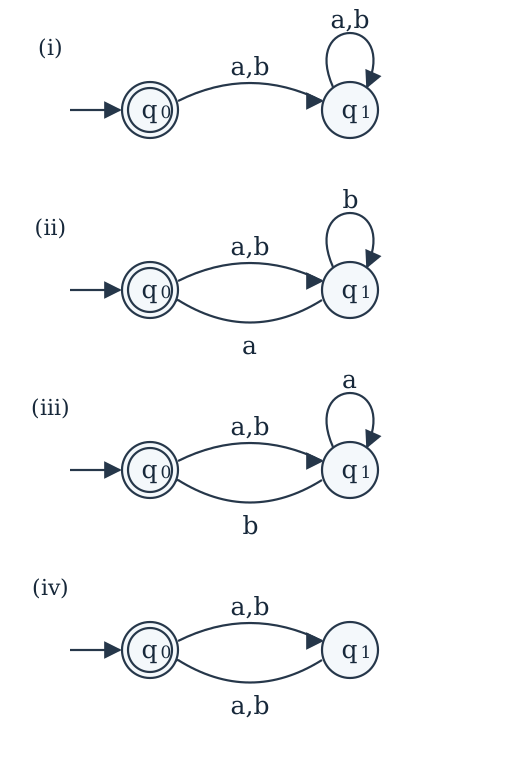
| 図 | δ(q1,a) | δ(q1,b) | 受理する言語の正規表現 |
|---|
| (i) | q1 | q1 | ε |
| (ii) | q0 | q1 | ((a+b)b∗a)∗ |
| (iii) | q1 | q0 | ((a+b)a∗b)∗ |
| (iv) | q0 | q0 | ((a+b)(a+b))∗ |
- (i) 空文字列だけである。1文字でも読むと q1 に移り、以後戻れない。言語は {ε} であり、空言語 ∅ ではない。
- (ii) 「任意の1文字、続いて0個以上の b、最後に a」というブロックを0回以上連結した文字列である。各ブロックが q0 から出て初めて q0 に戻る経路に対応する。
- (iii) 「任意の1文字、続いて0個以上の a、最後に b」というブロックを0回以上連結した文字列である。
- (iv) 長さが偶数である文字列である。文字の種類によらず、1文字読むたびに状態が切り替わる。
(3)
遷移関数は全体で 24=16 通りある。(1)、(2) で扱っていないものは、q0 からの遷移によって次の二つに分かれる。
δ(q0,a)=q1, δ(q0,b)=q0 の場合: a,b を交換すると (1) の場合になる。q1 からの遷移も同時に交換されるため、この場合の全4通りの受理言語は (1) のいずれかの交換言語であり、求める対象ではない。
δ(q0,a)=δ(q0,b)=q0 の場合: どの文字を読んでも q0 にとどまるため、q1 は到達不能である。したがって、δ(q1,a),δ(q1,b) の選び方4通りの全てについて、
L(M)=Σ∗={a,b}∗=∥(a+b)∗∥.
すなわち、空文字列を含む a,b 上の全ての文字列を受理する。(1) では b、(2) では a のように、各場合に少なくとも一つ不受理の文字列がある。文字の交換は全単射なので、それらの交換言語も Σ∗ にはならない。よって上記が求める言語であり、該当する遷移関数は4通りある。状態集合は指定どおり {q0,q1} のままでよい。
【問2】
(A)(1)
次の生成規則を与える。
SX→XaXaXaX,→aX∣bX∣ε.
X は {a,b}∗ の任意の文字列を生成する。S の規則には3個の a が明示されているので、生成される文字列の a は3個以上となる。逆に、a を3個以上含む文字列から3個の a を選ぶと、その前後と間を四つの X で生成できる。よって生成言語はちょうど L1 である。
(A)(2)
非終端記号を S だけとして、次の生成規則を与える。
S→∣∣∣∣SaSSaSaSbSSaSbSaSSbSaSaSε.
生成される文字列が条件を満たすこと。 d(w)=∣w∣a−2∣w∣b と置く。SaS は d を1増やし、他の三つの非空規則は a を2個、b を1個加えるので d を変えない。S→ε の値は0である。導出木について帰納すれば、生成される全ての文字列で d(w)≥0 となる。
条件を満たす全ての文字列を生成できること。 d(w)≥0 で b を含む文字列は、連続部分文字列 aab,aba,baa のいずれかを含む。実際、これらを全て含まないと仮定すると、a は連続できず、二つの a の間には少なくとも2個の b が必要になる。A=∣w∣a,B=∣w∣b とすると、B≥1 および A≥2B から A≥2 である一方、
B≥2(A−1),A≥2B⟹3A≤4
となり矛盾する。
そこで aab,aba,baa のいずれかを削除する。この操作は d(w) を変えず、b を1個減らすので、繰り返すと a だけの文字列になる。その a も1個ずつ削除して空文字列にできる。
これを逆にたどれば、空文字列から任意の位置へ a、aab、aba、baa を挿入して元の文字列を復元できる。上の文法では、挿入した文字の前後と各文字間に S を残せるため、これら全ての挿入を実現できる。最後に残った S を ε にすればよい。よって生成言語はちょうど L2 である。特に aa も S⇒SaS⇒SaSaS⇒aa と生成できる。
(A)(3)
条件の「または」に従って二つの言語の和に分ける。
L3={aib2ick∣i,k≥0}∪{aibjc3j∣i,j≥0}.
指定された N3={S,V,X,Y,Z} を用いて、
SVZXY→VZ∣XY,→aVbb∣ε,→cZ∣ε,→aX∣ε,→bYccc∣ε
とする。V は aib2i、Z は任意の ck を生成するので、VZ は第1の言語を生成する。X は任意の ai、Y は bjc3j を生成するので、XY は第2の言語を生成する。いずれも文字の順序 a∗b∗c∗ が保たれ、i,j,k=0 の場合も含まれる。したがって生成言語は L3 と一致する。
(B)(4)
L4=∅ は文脈自由言語である。 例えば、
G4=({S},{a},{S→S},S)
という文脈自由文法を考える。S からの導出では常に非終端記号 S が残り、終端記号だけからなる文字列は一つも得られない。したがって L(G4)=∅ である。ε も生成されないので、∅ と {ε} を混同していない。
(B)(5)
任意の有限言語 L5 は文脈自由言語である。 L5={w1,…,wm}(m≥1)と書き、その終端記号の集合を Σ とする。生成規則を
P5={S→wi∣1≤i≤m}
とすれば、文法 ({S},Σ,P5,S) が生成する文字列はちょうど w1,…,wm である。wi=ε なら S→ε を含めればよい。生成規則は有限個で、各右辺も有限長であるため、有効な文脈自由文法となる。なお、有限言語は正規言語でもある。
Reference
- 九州大学大学院システム情報科学府 情報理工学専攻:令和3年度入学試験問題、2020年12月5日実施、専門科目 C「オートマトンと言語」、【問1】【問2】。
- 九州大学:修士課程入試・過去問題案内