京都大学 情報学研究科 社会情報学コース 2026年度 情報学基礎 問題3
Author
祭音Myyura (Based on ymogi's answer refined with GPT 6 Astra)
Description
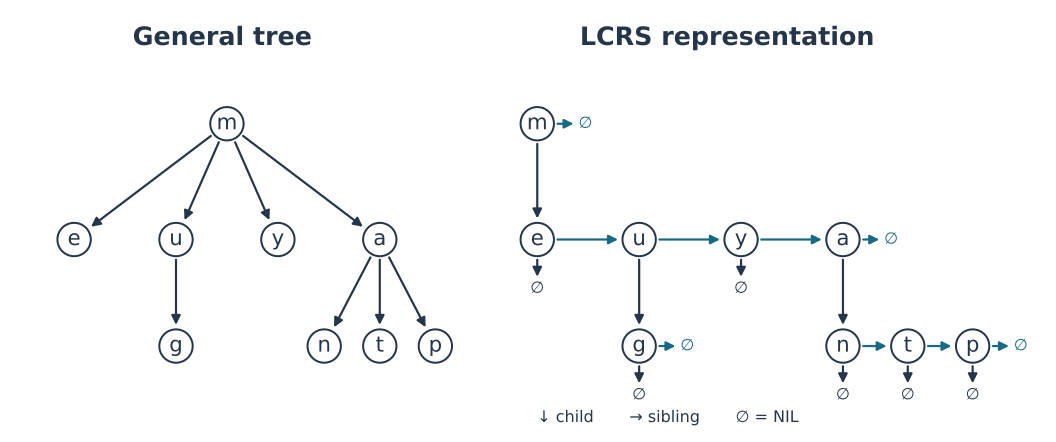
木は節点から構成される階層的データ構造であり,各節点は複数の子節点を持つことができる。単語の効率的な格納と検索のために広く用いられる変種の一つが,左の子・右の兄弟(Left-Child Right-Sibling,LCRS)木表現である。LCRS木では,各節点は二本のポインタを保ち,左の子へのポインタは単語中の次の文字を表す,右の兄弟へのポインタは同レベルの別の文字を表す。左の子や右の兄弟がいない場合,ポインタはNIL()である。この構造により,一般の多叉木を二分木形式に変換しつつ階層関係を保持する。図1は,一般木とそれに対応するLCRS木を,単語 me,mug,my,man,mat,map を格納した例で示している。以下では,単語は英語アルファベット26文字のみで構成される。
(1) 次の単語 sun,see,tea,win,way を逐次に挿入して新たに構築されたLCRS木を図示せよ。
(2) 以下に,LCRS木の節点の表現を示す。LCRS木から文字列を検索する擬似コードを記述せよ。文字列がLCRS木に含まれた際Trueを返し,それ以外はFalseを返すべき。
Structure Node:
    data    : 'a'から'z'までのアルファベット
    child   : 左の子へのポインタ
    sibling : 右の兄弟へのポインタ
(3) 単語長 に対する探索の最悪時間計算量をビッグオー記法で答えよ。ただし,単語の長さとは文字数とする。図1では,me と my の長さはいずれも2であるのに対し,mug,man,mat,map の長さはいずれも3である。
(4) 文字列の格納と取り出す処理においてLCRS木とハッシュテーブルを比較する。
- (a) ハッシュテーブルに10個の単語が格納されている場合,1つの単語を取り出す処理の最悪時間計算量を,ビッグオー記法で答えよ。
- (b) ハッシングを用いて10個の単語をスロット数20のハッシュテーブルに挿入した場合の負荷率を答えよ。
题目描述
树是由结点组成的层次数据结构,每个结点可以有多个子结点。左孩子右兄弟(LCRS)表示法常用于高效存储和检索单词。每个结点保留两个指针:child 指向最左子结点,表示单词中的下一个字符;sibling 指向右侧兄弟结点,表示同一层的其他字符。不存在相应结点时,指针为NIL()。这种表示将一般的多叉树转化为二叉树形式,同时保留原来的层次关系。图1给出了存储 me、mug、my、man、mat、map 的一般树及其LCRS表示。以下单词仅由26个英文字母组成。
(1) 依次插入 sun、see、tea、win、way,画出新构建的LCRS树。
(2) 每个结点具有 data、child、sibling 三个字段,分别表示 'a' 至 'z' 的字母、最左子结点指针和右兄弟指针。编写在LCRS树中搜索字符串的伪代码:字符串包含在树中时返回True,否则返回False。
(3) 用大O记号表示搜索长度为 的单词的最坏时间复杂度。单词长度指字符数。例如,图1中 me、my 的长度为2,其余四个单词的长度为3。
(4) 比较LCRS树与哈希表在字符串存储和检索方面的表现。
- (a) 一个哈希表中存有10个单词,用大O记号给出检索一个单词的最坏时间复杂度。
- (b) 将10个单词插入具有20个槽的哈希表,其负载因子是多少?
Kai
(1)
空の木から構築し,新しい兄弟を既存の兄弟列の末尾へ追加する。最上位の兄弟列は s → t → w となり,s の子の兄弟列は u → e,w の子の兄弟列は i → a となる。
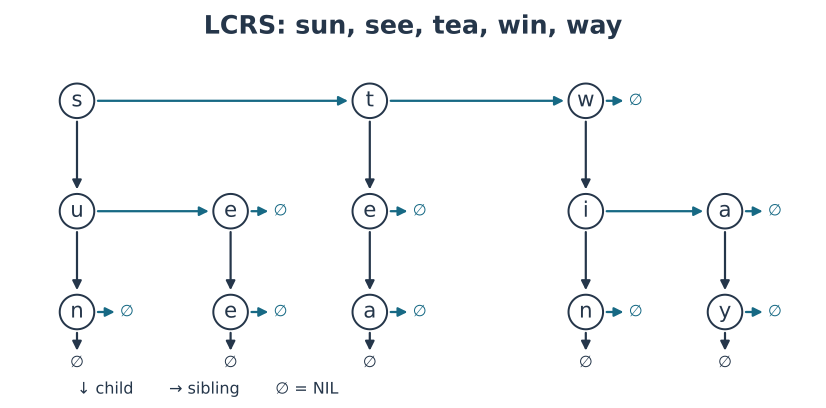
縦の矢印は child,横の矢印は sibling を表す。兄弟方向へ進んでも単語中の文字位置は変化せず,子方向へ進むと次の文字位置に移る。
(2)
図1および(1)の単語集合では,どの単語も他の単語の接頭辞ではないため,単語終端を child = NIL で識別できる。この場合,格納された単語全体との一致を判定する擬似コードは次のようになる。root は最上位の兄弟列の先頭,文字列の添字は0始まりとする。
SEARCH_WORD(root, word):
    k ← length(word)
    if k = 0:
        return False

    p ← root
    for i ← 0 to k - 1:
        while p ≠ NIL and p.data ≠ word[i]:
            p ← p.sibling

        if p = NIL:
            return False
        if i = k - 1:
            return (p.child = NIL)

        p ← p.child
一致する文字は同じ兄弟列から探す。見つかれば子へ降りて次の文字を照合する。最後の文字まで一致しても子が残る場合,検索語は格納語の真の接頭辞なのでFalseとする。例えば,(1)の木に対して sun はTrue,su はFalseとなる。
一般に,a と ab のように単語とその延長を同時に格納する場合,題示の3フィールドだけでは単語終端を識別できない。この場合は終端フラグ is_word を各節点に追加し,終端判定を return p.is_word に置き換える必要がある。一方,設問の「文字列が含まれる」を先頭からの文字経路の存在と解釈する場合は,終端判定を return True とし,接頭辞も受理する。
(3)
同じ兄弟列に同一文字を重複させないので,1文字の照合で調べる節点は高々26個である。これを高々 文字について行うため,最悪時間計算量は
(4)
(a)
格納語数を とする。ハッシュ値の計算と1回のキー比較を定数時間とする通常のモデルでは,衝突によって全単語を調べる場合が最悪である。例えば,連鎖法で全単語が同じバケットに入り,目的の語が最後尾にある場合である。したがって
となり, では最悪10語を調べる。10を固定値としてのみ扱えば である。
文字ごとの処理も数える場合,長さ の検索語のハッシュ計算に ,各文字列比較に最悪 を要するので,最悪時間計算量は となる。このモデルでは を固定すると である。
(b)
負荷率は「格納要素数/スロット数」なので,