京都大学 情報学研究科 知能情報学専攻 2021年7月実施 情報学基礎 F2-1 Author Isidore , 祭音Myyura
Description 設問1
整数の集合 A A A k k k ( k ≥ 1 ) (k \ge 1) ( k ≥ 1 ) SelectKth ( A , k ) \text{SelectKth}(A,k) SelectKth ( A , k ) A = { 5 , 1 , 7 } A = \{5,1,7\} A = { 5 , 1 , 7 } k = 2 k = 2 k = 2 SelectKth ( A , k ) \text{SelectKth}(A,k) SelectKth ( A , k ) 5 5 5 p : = PivotSelect ( A ) p:= \text{PivotSelect}(A) p := PivotSelect ( A ) A A A ( L , R ) : = Partition ( A , p ) (L,R):= \text{Partition}(A,p) ( L , R ) := Partition ( A , p ) A A A p p p L L L p p p R R R A = { 5 , 1 , 7 } A = \{5,1,7\} A = { 5 , 1 , 7 } p = 5 p = 5 p = 5 ( L , R ) : = Partition ( A , p ) (L,R):= \text{Partition}(A,p) ( L , R ) := Partition ( A , p ) L L L R R R L = { 5 , 1 } L = \{5,1\} L = { 5 , 1 } R = { 7 } R = \{7\} R = { 7 } Remove ( A , p ) \text{Remove}(A,p) Remove ( A , p ) A A A p p p A = { 5 , 1 , 7 } A = \{5,1,7\} A = { 5 , 1 , 7 } p = 7 p = 7 p = 7 Remove ( A , p ) \text{Remove}(A,p) Remove ( A , p ) A A A { 5 , 1 } \{5,1\} { 5 , 1 } ∣ X ∣ |X| ∣ X ∣ X X X A A A
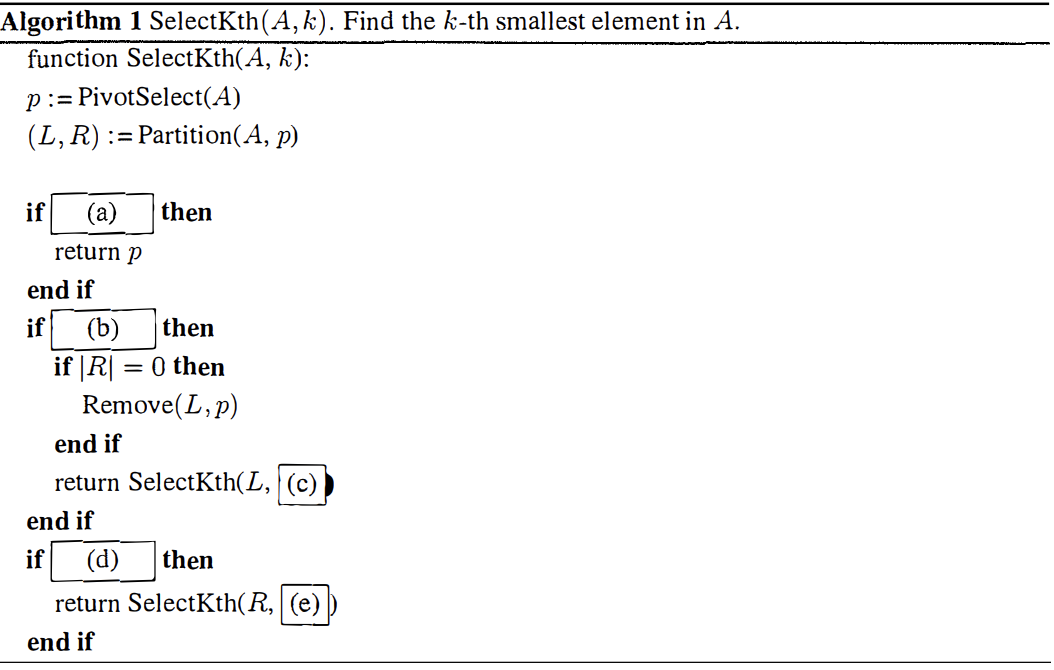
(1) Algorithm 1 は SelectKth 関数の疑似コードである。Algorithm 1 の (a)-(e) を埋めよ。
(2) ∣ A ∣ = n |A| = n ∣ A ∣ = n Partition ( A , p ) \text{Partition}(A,p) Partition ( A , p ) Remove ( L , p ) \text{Remove}(L,p) Remove ( L , p ) PivotSelect ( A ) \text{PivotSelect}(A) PivotSelect ( A ) O ( n ) O(n) O ( n ) O ( n ) O(n) O ( n ) O ( 1 ) O(1) O ( 1 )
設問2
4 4 4 0 , 1 , 2 0,1,2 0 , 1 , 2 4 4 4 s 4 s 3 s 2 s 1 , s i ∈ { 0 , 1 , 2 } s_4s_3s_2s_1,s_i \in \{0,1,2\} s 4 s 3 s 2 s 1 , s i ∈ { 0 , 1 , 2 } mod \text{ mod } mod
(1) 表 1 1 1 ( ∑ i = 1 4 3 i − 1 s i ) mod 4 \big(\sum_{i = 1}^4 3^{i - 1}s_i\big) \text{ mod } 4 ( ∑ i = 1 4 3 i − 1 s i ) mod 4 0100 , 1211 0100,1211 0100 , 1211 0010 , 2101 , 1222 , 1111 0010,2101,1222,1111 0010 , 2101 , 1222 , 1111 1 1 1
(2) k k k 1 1 1 c k ( c は正の実定数 ) ck(c\text{は正の実定数}) c k ( c は正の実定数 ) 2 2 2 2 2 2
(3) (2) で求めた対応付けを ( ∑ i = 1 4 a i s i + a 5 s 1 s 2 + a 6 s 3 s 4 ) mod 4 \big(\sum_{i = 1}^4 a_is_i + a_5s_1s_2 + a_6s_3s_4\big)\text{ mod } 4 ( ∑ i = 1 4 a i s i + a 5 s 1 s 2 + a 6 s 3 s 4 ) mod 4 a 1 , a 2 , a 3 , a 4 , a 5 , a 6 a_1,a_2,a_3,a_4,a_5,a_6 a 1 , a 2 , a 3 , a 4 , a 5 , a 6
インデックス リスト 0 1 0100 → \rightarrow → 2 3
キー 生起確率 ハッシュ値 0100 0.10 (a) 0210 0.20 (b) 1010 0.15 0 1101 0.15 1 1111 0.25 (c) 2101 0.15 (d)
题目描述
问题 1 考虑函数 SelectKth ( A , k ) \operatorname{SelectKth}(A,k) SelectKth ( A , k ) A A A k k k k ≥ 1 k\ge1 k ≥ 1 A = { 5 , 1 , 7 } A=\{5,1,7\} A = { 5 , 1 , 7 } k = 2 k=2 k = 2 p : = PivotSelect ( A ) p:=\operatorname{PivotSelect}(A) p := PivotSelect ( A ) A A A ( L , R ) : = Partition ( A , p ) (L,R):=\operatorname{Partition}(A,p) ( L , R ) := Partition ( A , p ) A A A p p p L L L p p p R R R A = { 5 , 1 , 7 } A=\{5,1,7\} A = { 5 , 1 , 7 } p = 5 p=5 p = 5 L = { 5 , 1 } L=\{5,1\} L = { 5 , 1 } R = { 7 } R=\{7\} R = { 7 }
Remove ( A , p ) \operatorname{Remove}(A,p) Remove ( A , p ) A A A p p p A = { 5 , 1 , 7 } A=\{5,1,7\} A = { 5 , 1 , 7 } p = 7 p=7 p = 7 A A A { 5 , 1 } \{5,1\} { 5 , 1 } ∣ X ∣ |X| ∣ X ∣ X X X A A A
上方 Algorithm 1 为寻找 A A A k k k
(1)填写 Algorithm 1 中的空栏(a)~(e)。
(2)当 ∣ A ∣ = n |A|=n ∣ A ∣ = n Partition ( A , p ) \operatorname{Partition}(A,p) Partition ( A , p ) Remove ( L , p ) \operatorname{Remove}(L,p) Remove ( L , p ) PivotSelect ( A ) \operatorname{PivotSelect}(A) PivotSelect ( A ) O ( n ) O(n) O ( n ) O ( n ) O(n) O ( n ) O ( 1 ) O(1) O ( 1 )
问题 2 回答关于使用 4 个链表的外部哈希法的问题。键是 4 个取值于 { 0 , 1 , 2 } \{0,1,2\} { 0 , 1 , 2 } s 4 s 3 s 2 s 1 s_4s_3s_2s_1 s 4 s 3 s 2 s 1 s i ∈ { 0 , 1 , 2 } s_i\in\{0,1,2\} s i ∈ { 0 , 1 , 2 } m o d \bmod mod
(1)表 1 示意使用哈希函数
( ∑ i = 1 4 3 i − 1 s i ) m o d 4 \left(\sum_{i=1}^4 3^{i-1}s_i\right)\bmod4 ( i = 1 ∑ 4 3 i − 1 s i ) mod 4 依次插入键 0100,1211 后的数据结构。在此状态下继续依次插入 0010,2101,1222,1111,仿照表 1 画出最终的数据结构。
表 1:
(2)向含 k k k c k ck c k c c c
表 2:
键 发生概率 哈希值 01000.10 (a) 02100.20 (b) 10100.15 0 11010.15 1 11110.25 (c) 21010.15 (d)
(3)用哈希函数
( ∑ i = 1 4 a i s i + a 5 s 1 s 2 + a 6 s 3 s 4 ) m o d 4 \left(\sum_{i=1}^4a_is_i+a_5s_1s_2+a_6s_3s_4\right)\bmod4 ( i = 1 ∑ 4 a i s i + a 5 s 1 s 2 + a 6 s 3 s 4 ) mod 4 实现(2)所得对应,推导 a 1 , a 2 , a 3 , a 4 , a 5 , a 6 a_1,a_2,a_3,a_4,a_5,a_6 a 1 , a 2 , a 3 , a 4 , a 5 , a 6
Kai 設問1
(1)
a. ∣ L ∣ = k |L| = k ∣ L ∣ = k
b. ∣ L ∣ > k |L| > k ∣ L ∣ > k
c. k k k
d. ∣ L ∣ < k |L| < k ∣ L ∣ < k
e. k − ∣ L ∣ k - |L| k − ∣ L ∣
(2)
Note that Algorithm 1 is so called "Quick Select" algorithm.
Let T n T_n T n n n n c n cn c n j j j
s ( j ) = { n − j , j < k , 0 , j = k , j , k < j < n , n − 1 , j = n > k . s(j)=
\begin{cases}
n-j,&jk.
\end{cases} s ( j ) = ⎩ ⎨ ⎧ n − j , 0 , j , n − 1 , j < k , j = k , k < j < n , j = n > k . For every k k k
1 n ∑ j = 1 n s ( j ) ≤ 3 n 4 . \frac1n\sum_{j=1}^n s(j)\leq\frac{3n}{4}. n 1 j = 1 ∑ n s ( j ) ≤ 4 3 n . Thus, by induction with C ≥ 4 c C\geq4c C ≥ 4 c
T n ≤ c n + 1 n ∑ j = 1 n T s ( j ) ≤ c n + C 3 n 4 ≤ C n . T_n\leq cn+\frac1n\sum_{j=1}^n T_{s(j)}
\leq cn+C\frac{3n}{4}\leq Cn. T n ≤ c n + n 1 j = 1 ∑ n T s ( j ) ≤ c n + C 4 3 n ≤ C n . Therefore, T n = O ( n ) T_n=O(n) T n = O ( n )
設問2
(1)
index list 0 2101 -> 1111 1 0100 -> 1211 -> 1222 2 3 0010
(2)
(a): 0
(b): 2
(c c c
(d): 1
Let q h q_h q h h h h t t t c t ∑ h = 0 3 q h 2 ct\sum_{h=0}^3q_h^2 c t ∑ h = 0 3 q h 2
( q 0 , q 1 , q 2 , q 3 ) = ( 0.25 , 0.30 , 0.20 , 0.25 ) , ∑ h = 0 3 q h 2 = 0.255 , \begin{gathered}
(q_0,q_1,q_2,q_3)=(0.25,0.30,0.20,0.25),\\
\sum_{h=0}^3q_h^2=0.255,
\end{gathered} ( q 0 , q 1 , q 2 , q 3 ) = ( 0.25 , 0.30 , 0.20 , 0.25 ) , h = 0 ∑ 3 q h 2 = 0.255 , which is the minimum over the possible assignments of (a)--(d).
(3)
Construct a system of six linear equations in six variables from the table given in (2), and we have
a 1 = 1 a 2 = 2 a 3 = 0 a 4 = − 2 a 5 = 0 a 6 = 2 \begin{aligned}
a_1 &= 1 \\
a_2 &= 2 \\
a_3 &= 0 \\
a_4 &= -2 \\
a_5 &= 0 \\
a_6 &= 2 \\
\end{aligned} a 1 a 2 a 3 a 4 a 5 a 6 = 1 = 2 = 0 = − 2 = 0 = 2 Reference